Коротко
Внутренний, или корпоративный, ChatGPT — это не просто окно чата с логотипом компании. Рабочая версия больше похожа на слой поверх корпоративных знаний: она знает, какие источники считаются надёжными, какие материалы видит конкретный сотрудник, когда нужно искать, когда лучше отказаться и где пора вернуть задачу человеку.
Первая ошибка — подключить “все документы” и надеяться, что модель разберётся. Не разберётся. Корпоративному ассистенту нужны владельцы источников, актуальность, metadata, права доступа и поиск, который умеет находить и смысл, и точные термины. То есть нужен RAG, но вместе с полнотекстовым поиском, фильтрами, reranking, ссылками на источники и честными отказами.
Безопасность нельзя прикрутить в конце. В документации Microsoft про Copilot Search отдельно сказано, что корпоративный поиск должен уважать существующие права доступа. OpenAI в материалах для бизнеса тоже отделяет данные клиентов от обучения моделей по умолчанию. Это полезные обещания поставщиков, но они не заменяют собственную архитектуру: в приложении всё равно нужны identity, authorization, audit logs, retention и проверка того, что попадает в prompt.
Вопрос не в том, “можно ли сделать свой ChatGPT”. Можно. Вопрос лучше поставить иначе: какую работу сотрудники смогут ему доверить? Искать регламенты — один уровень. Готовить черновик ответа — другой. Создавать заявку, менять CRM или отправлять сообщение — уже зона подтверждений, журналов и evals.
Внутренний ChatGPT или подписка на ChatGPT
С корпоративной подписки на ChatGPT, Claude или Copilot удобно начинать: сотрудники получают сильную модель, а базовую безопасность берёт на себя поставщик. Внутренний ассистент строится под конкретный процесс и его документы.
| Корпоративная подписка | Внутренний ассистент | |
|---|---|---|
| Знания | то, что сотрудник загрузил сам или до чего дотянулись коннекторы | источники, отобранные и подготовленные под процесс, у каждого есть владелец |
| Доступ | роли в рабочем пространстве поставщика | ваши роли, применённые до того, как модель увидит текст |
| Ответы | общие ответы модели, иногда со ссылкой на источник | ответы только по утверждённым документам со ссылкой на страницу |
| Действия | в основном текст | заявки, записи в CRM и черновики по правилам подтверждения |
| Качество | доверие поставщику | набор реальных вопросов, который прогоняют после каждого изменения |
Если сотрудникам нужна помощь с текстами и размышлениями, подписки хватит. Если нужны ответы, за которые компания готова отвечать, нужен свой ассистент.
Начните с задачи, а не с чата
Большинство проектов внутреннего ассистента стартует слишком широко: “пусть сотрудники спрашивают что угодно”. Звучит щедро, но это трудно построить и ещё труднее контролировать. Лучше выбрать один болезненный процесс.
Например:
- вопросы сотрудников по HR-политикам;
- помощь продажам по презентациям, правилам цены и CRM-заметкам;
- ответы поддержки по документации и закрытым тикетам;
- поиск юридических шаблонов и объяснение пунктов договора;
- onboarding новых руководителей;
- операционный поиск по SOP, таблицам и внутренним системам.
У каждого процесса свой риск. HR требует аккуратных ролей доступа и осторожных формулировок. Продажам нужны свежие цены и ограничения на обещания клиенту. Поддержке нужны источники и эскалация. Юристам важно, чтобы ассистент отличал “объясни пункт” от “одобри договор”.
Поэтому внутренний ассистент быстро оказывается в том же разговоре, что и стоимость внедрения ИИ. Вызов модели — не самая сложная часть. Сложнее решить, что система имеет право знать, говорить и делать.
Качество начинается с владельцев источников
До retrieval нужна инвентаризация источников. Не красивая enterprise-схема. Обычной таблицы хватит:
- название источника;
- владелец со стороны бизнеса;
- где источник лежит технически;
- тип документа;
- как часто он должен обновляться;
- группа доступа;
- чувствительность;
- путь обновления;
- это утверждённый источник или только контекст.
Так ловится типовая проблема: ассистент отвечает по старому PDF, потому что никто не сказал системе, что свежий Google Doc его заменил. Или цитирует черновик, потому что черновики и утверждённые политики лежат в одной папке. Или смешивает публичный sales deck с внутренними правилами маржи.
В этом мало блеска. Зато именно так появляется доверие. Каждый важный ответ должен вести к источнику, за который кто-то отвечает.
Как подготовить документы компании для ассистента
Чаще всего от внутреннего ChatGPT ждут одного: сотрудник спрашивает про документы компании и получает ответ со ссылкой на нужную страницу. Упирается всё обычно не в модель, а в сами документы.
Знания компании обычно разбросаны по PDF, сканам договоров, Word-файлам, таблицам, страницам Confluence или Notion, папкам Google Drive и вложениям в почте. Каждый формат нужно подготовить, прежде чем по нему можно будет искать:
- сканы проходят через OCR, а качество распознавания проверяют на живых примерах, а не принимают на веру;
- длинные регламенты режут по их собственной структуре (разделам, пунктам, нумерации), а не по фиксированному числу символов, чтобы ответ ссылался на «пункт 4.2», а не на случайный кусок;
- таблицы остаются таблицами: прайс, превращённый в сплошной текст, теряет связь между ценой и строкой;
- у каждого фрагмента сохраняются метаданные: источник, версия, владелец, дата, группа доступа;
- старые версии удаляют или помечают как заменённые, иначе ассистент будет их цитировать.
Для пилота хватит простой проверки. Возьмите 30-50 реальных вопросов, которые сотрудники уже задают в чатах и по почте, и посмотрите, находит ли ассистент нужную страницу для каждого. Если поиск промахивается, сначала чините подготовку документов, а промпт трогайте потом. На этом же подходе построены ИИ-ассистент по документам и агент для проверки документов.
В базе знаний Magnum для сотрудников ответ обычно спрятан в одном абзаце одного PDF из сотен. Поиск там гибридный: векторный (эмбеддинги BGE-M3 в Qdrant) плюс полнотекстовый, с переранжированием результатов. OCR достаёт таблицы и схемы, которые вставлены в PDF картинками. Команда сама загружает и заменяет документы в админке, без инженеров, а система переиндексирует их автоматически. Каждое изменение проверяется на бенчмарке из 100 реальных вопросов сотрудников на русском и казахском.
Роли доступа должны сработать до модели
У доступа во внутреннем ChatGPT простое правило: нельзя доставать из поиска то, что пользователь не имеет права видеть.
Не стоит рассчитывать, что модель “сохранит тайну”, если секретный текст уже попал в prompt. Если данные по зарплатам, юридические заключения, материалы совета директоров или PII клиента оказались в context window не того сотрудника, система уже ошиблась, даже если финальный ответ звучит безобидно.
Практичная модель ролей обычно включает:
- identity сотрудника из SSO;
- отдел и команду;
- права на документ в исходной системе;
- отдельные метки чувствительности для legal, HR, finance и leadership;
- временный доступ для проектов;
- отказ, который объясняет проблему, но не раскрывает скрытое содержимое.
Microsoft для Copilot Search описывает тот же принцип: возвращать только то, к чему у пользователя уже есть доступ. Если вы строите свой ассистент, эта ответственность переходит к вам.
RAG нужен, но одного RAG мало
RAG помогает отвечать по материалам компании, а не по памяти модели. Это важно: модель не знает ваш последний регламент, шаблон договора, правило доставки или исключение в поддержке.
Но RAG — это не один компонент. В production это цепочка:
- забрать источники;
- нормализовать текст, таблицы и metadata;
- сохранить версии и даты;
- нарезать документы вокруг реальных вопросов;
- найти кандидатов;
- переупорядочить их;
- собрать контекст;
- ответить со ссылками;
- отказаться, если данных не хватает.
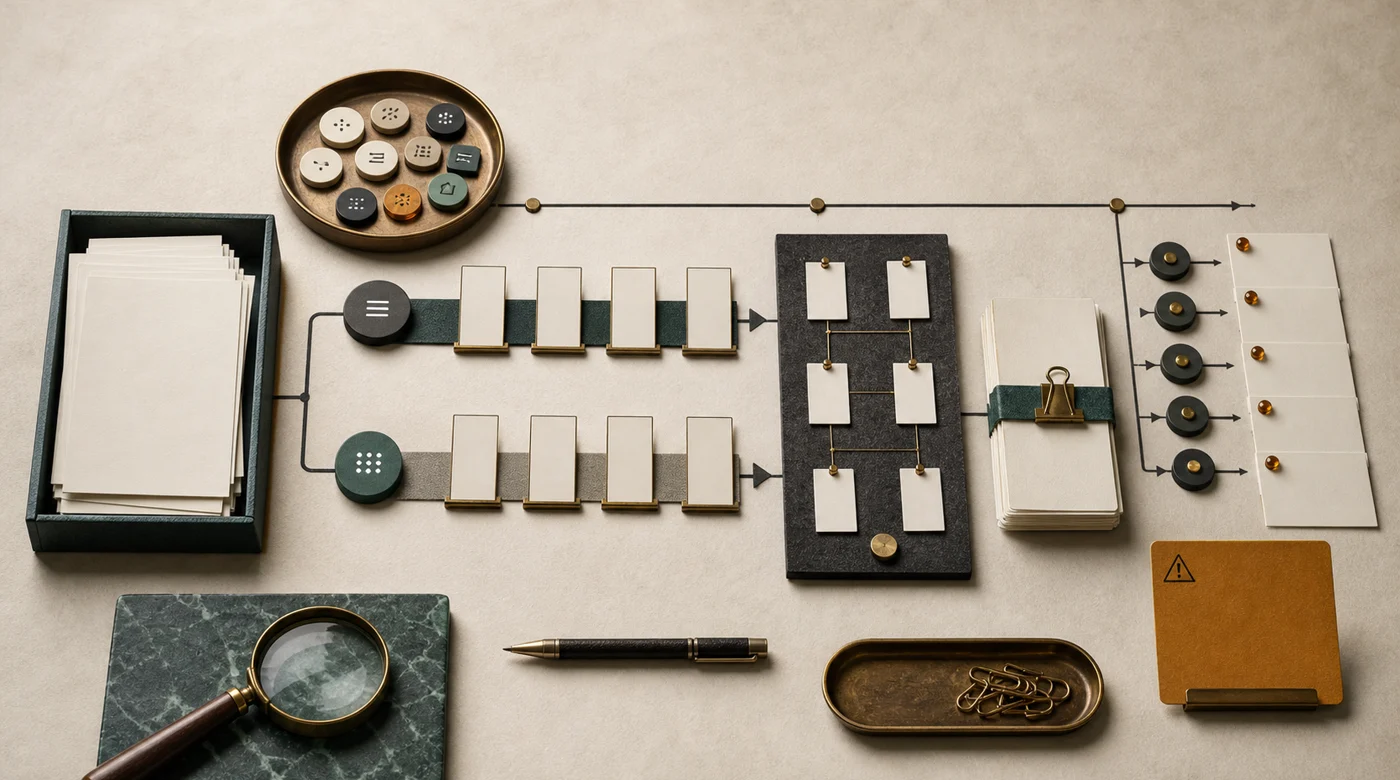
Подробно это разобрано в статье Как построить хороший RAG. Для внутреннего ассистента вывод простой: vector database сама по себе не превращает документы в систему знаний.
Поиск должен понимать точные слова и человеческий хаос
Сотрудники не задают аккуратные benchmark-вопросы. Они вставляют куски переписки, используют сокращения, смешивают языки, спрашивают “где та форма, которую мы брали в прошлом квартале?” или ищут по номеру договора.
Vector search помогает со смыслом. Full-text search помогает с точными словами. Metadata-фильтры сужают выдачу по отделу, дате, типу документа, продукту, клиенту, региону или роли. Reranking помогает выбрать лучшие доказательства после того, как несколько поисковых дорожек вернули кандидатов.
Hybrid search почти всегда нужен, если в базе есть:
- номера счетов, SKU, VIN, contract IDs, ticket IDs;
- названия продуктов, кампаний, филиалов и клиентов;
- таблицы и исключения из правил;
- двуязычные или многоязычные материалы;
- старые и новые версии похожих документов;
- внутренние сокращения.
Здесь полезны исследования по оценке RAG, например Ragas: они разделяют качество retrieval и качество финального ответа. Если источник найден неверно, правка тона ответа систему не спасёт.
Ответу нужны источники, отказы и границы уверенности
Ассистент не должен звучать увереннее, чем позволяют источники.
Для внутреннего применения хороший формат ответа обычно такой:
- прямой ответ в начале;
- источники с названием, датой и владельцем, если это возможно;
- короткая пометка о предположениях;
- отказ, если источники не подтверждают ответ;
- совет по передаче человеку для рискованных или двусмысленных случаев.
Это не вопрос вежливости. Это меняет поведение пользователей. Когда сотрудник видит источник, он понимает, читает ли ассистент правильный материал. Когда ассистент нормально отказывает, люди перестают принимать каждый уверенный абзац за корпоративную политику.
Отказ должен помогать: “Я не нашёл утверждённую travel policy для подрядчиков. Есть политика для сотрудников от марта 2026 года, но подрядчики там не упомянуты. Уточните у Finance или добавьте правило для подрядчиков в базу источников.” Это лучше, чем пустое “я не могу ответить”.
Логи превращают чат в систему, которая учится
Без логов ассистент быстро становится ещё одной бесхозной базой знаний. Месяц он кажется полезным, потом качество тихо уезжает.
Полезные логи сохраняют:
- роль пользователя, не обязательно все персональные детали;
- запрос и язык;
- ID и версии найденных источников;
- финальный ответ;
- причину отказа;
- вызванные tools;
- задержку и модель;
- feedback и оспаривание ответа;
- была ли эскалация.
С логами надо быть осторожным: они сами становятся чувствительными данными. Там могут оказаться вопросы сотрудников, имена клиентов, медицинские детали, юридические проблемы или случайно вставленные пароли. Нужны retention, masking, роли доступа и путь удаления.
OWASP Top 10 for LLM Applications 2025 отдельно выделяет prompt injection и sensitive information disclosure. Для внутреннего ассистента логи входят в эту поверхность риска, а не просто помогают наблюдать систему.
Безопасность и governance — часть продукта
Модель безопасности должна быть видна в плане продукта. NIST AI Risk Management Framework полезен тем, что описывает риск AI как постоянную работу: govern, map, measure, manage. NIST Generative AI Profile добавляет более конкретные риски для генеративных систем.
Для внутреннего ChatGPT governance означает:
- зафиксированных владельцев источников;
- утверждённые use cases;
- классификацию данных;
- ревизию доступов;
- историю изменений prompt и модели;
- процесс инцидентов;
- правила хранения логов;
- review поставщика и deployment;
- release gates для рискованных изменений.
Это не значит, что каждой компании нужен огромный AI-комитет. Но кто-то должен уметь ответить на скучный вопрос: кто имеет право менять ассистента и как мы узнаём, что изменение не сломало ответы по зарплатам, юристам, продажам или поддержке?
Если ассистент касается клиентов, регулируемых данных или решений по сотрудникам, governance становится строже. EU AI Act тоже двигает рынок к более понятной документации и классификации рисков, особенно для high-risk use cases. Даже вне ЕС направление видно: недокументированный AI внутри бизнес-процессов будет плохо стареть.
Evals показывают, становится ли ассистент лучше
Внутреннему ассистенту нужны evals до широкого запуска.
Начните небольшим набором. Возьмите 30-50 реальных вопросов и ожидаемые источники. Добавьте неприятные случаи: старые названия политик, отсутствующие документы, вопросы с ограниченным доступом, двуязычные формулировки, точные ID и вопросы, где ассистент обязан отказать.
Для RAG проверяйте:
- нашёл ли retrieval правильный источник;
- не достал ли источник, закрытый для пользователя;
- остался ли ответ внутри доказательств;
- подтверждают ли ссылки конкретные тезисы;
- отказался ли ассистент, когда данных не хватает.
Для действий проверяйте:
- выбрал ли он правильный tool;
- передал ли безопасные аргументы;
- попросил ли подтверждение;
- оставил ли понятный audit trail;
- остановился ли, когда обязательных данных нет.
Вот где evals для AI-проектов становятся практикой, а не украшением. Они позволяют менять prompts, модели, retrieval и tools без гадания на ощущениях.
Границы действий нужно назвать вслух
Внутренний ассистент может двигаться по уровням полномочий:
- ответить по утверждённым источникам;
- кратко пересказать документ;
- подготовить черновик сообщения или заявки;
- подготовить изменение в CRM или HRIS;
- создать задачу после подтверждения;
- действовать автоматически в низкорисковых случаях.
Для каждого шага нужна своя безопасность. Черновик обычно безопасен, если человек его смотрит. Обновление CRM рискованнее: плохие данные расходятся по процессу. Отправка письма клиенту или одобрение расхода — ещё выше.
Нормальная схема развивается постепенно. Сначала ассистент только отвечает. Потом пишет черновики, когда логи и evals стабильны. Затем делает действия с подтверждением в узких сценариях. Автоматизировать стоит только там, где цена ошибки низкая и восстановление простое.
Разницу между chat, workflow и agent подробнее разбирает статья AI-агент, chatbot или workflow: в чём разница.
Эксплуатация после запуска
Первый запуск — не финиш. Это момент, когда система впервые встречает живые формулировки, отсутствующие документы и нормальное человеческое нетерпение.
В эксплуатации нужны:
- еженедельный разбор плохих и оспоренных ответов;
- проверка свежести источников;
- ревизия access drift;
- журнал изменений prompt и retrieval;
- мониторинг стоимости и задержки;
- routing моделей для простых и сложных запросов;
- порядок обработки инцидентов;
- процесс добавления новых отделов и источников.
У ассистента должен быть понятный feedback. Например: “не тот источник”, “устаревший ответ”, “проблема доступа”, “полезно”. Начать можно очень просто. Главное, чтобы feedback кто-то читал, а владельцы источников могли действовать.
Хороший внутренний ChatGPT — это не модель, которая притворяется коллегой. Это управляемая retrieval-and-action система с интерфейсом чата.
Стройте её от источников, ролей, поиска, логов, evals и операционных правил. Пусть ассистент показывает доказательства. Пусть отказывается. Пусть просит подтверждение. Пусть улучшается от реального использования.
Это звучит менее магически, чем “ChatGPT для всей компании”. Зато именно такой версией сотрудники смогут пользоваться каждый день.
FAQ
Что такое корпоративный ChatGPT?
Корпоративным, или внутренним, ChatGPT называют ассистента компании, который отвечает сотрудникам по утверждённым внутренним источникам: регламентам, инструкциям, договорам, документации и записям в CRM. В отличие от публичного чат-бота, он учитывает права доступа, показывает документ, на котором основан ответ, честно отказывает, когда в источниках ответа нет, и записывает вопросы для разбора.
Может ли он отвечать по PDF, сканам и таблицам?
Да, если документы сначала подготовить. Сканы проходят OCR с проверкой на живых примерах, длинные регламенты делятся по своим разделам, таблицы остаются таблицами, а не превращаются в сплошной текст. Большая часть неверных ответов у ассистентов по документам идёт от плохой подготовки документов, а не от модели.
Будут ли наши документы использоваться для обучения модели?
По умолчанию нет: так записано в бизнес-условиях и условиях API крупных поставщиков, например OpenAI и Anthropic. Но обещание поставщика не заменяет архитектуру. Нужно решить, какие данные можно отправлять в облачную модель, замаскировать чувствительные поля и прописать хранение и доступ в договоре. В Казахстане базы с персональными данными по закону должны храниться в стране, и это стоит проверить до выбора модели.
Сколько времени занимает первая версия?
Пилот по одному набору документов для одной команды обычно занимает три-пять недель. За это время составляют список источников, готовят документы, настраивают поиск с учётом ролей, собирают проверочные вопросы и разбирают ответы с пользователями. Дальше ассистент расширяют на другие отделы, источник за источником.
Как понять, что ассистент отвечает правильно?
Соберите набор из 100-200 реальных вопросов сотрудников с эталонными ответами и документами-источниками. Проверяйте отдельно поиск и итоговый ответ и прогоняйте набор после каждого изменения промпта, модели или документов. Подробно метод разобран в статье что такое evals.